


RAG простыми словами: ИИ-помощник по документам компании
Как устроен RAG-поиск по документам: подготовка PDF, ответы с источниками, права доступа и проверка качества. Практический план запуска ИИ-помощника для бизнеса.
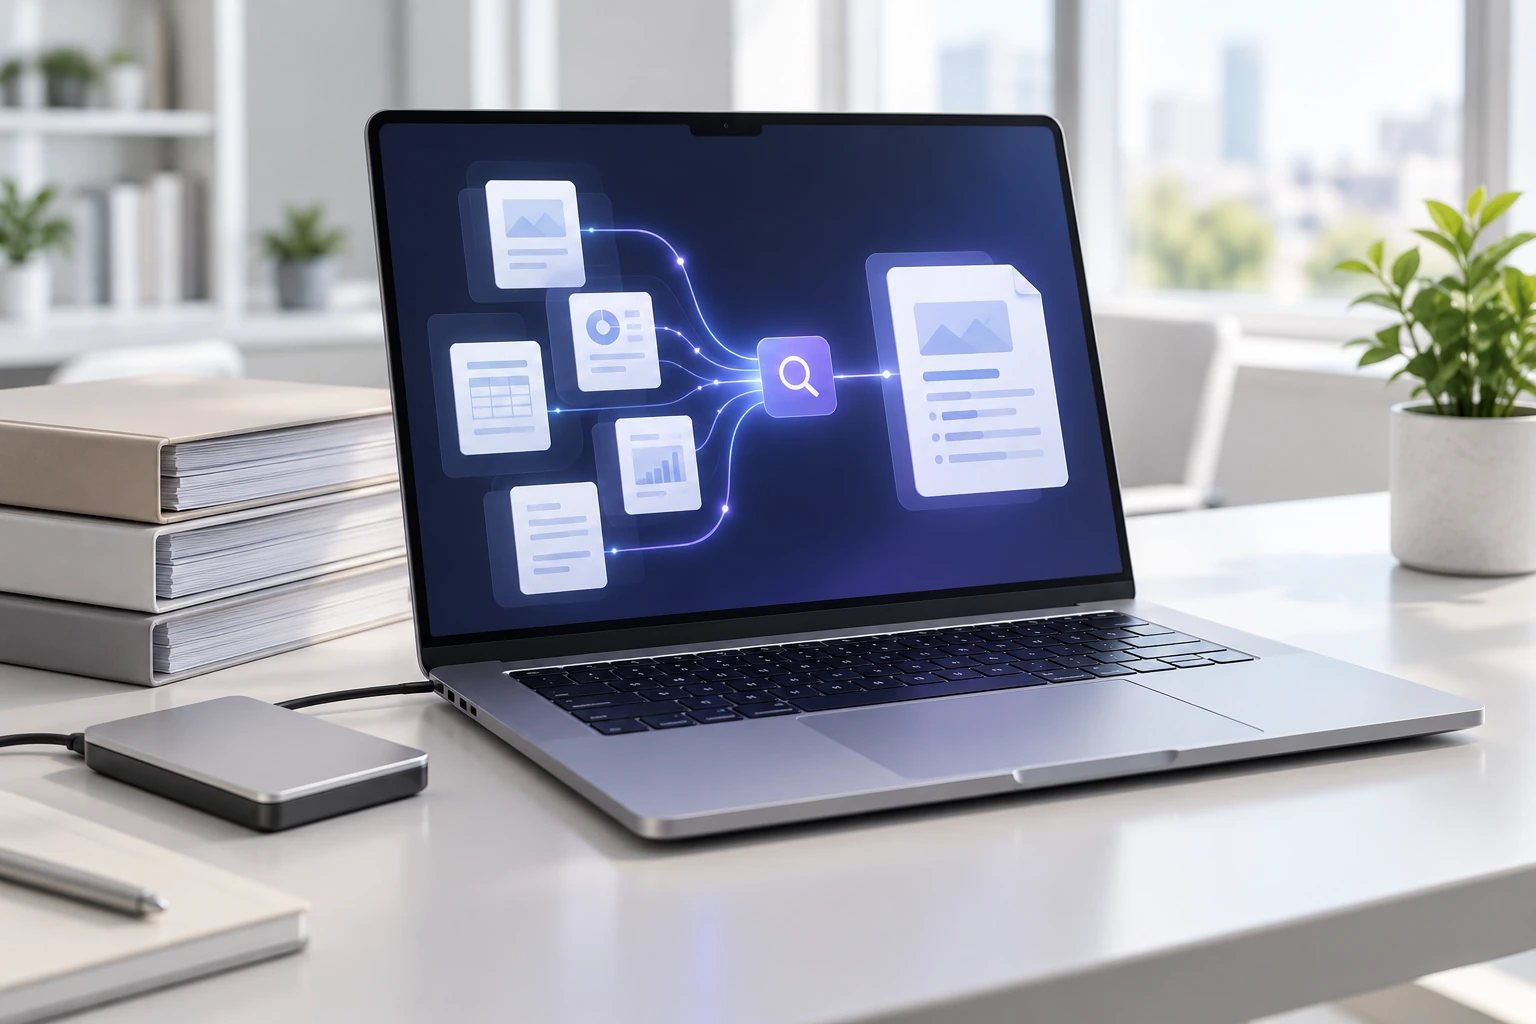
В папках компании могут лежать инструкции, прайс-листы и регламенты, но сотрудник всё равно спрашивает коллегу, где найти нужный пункт. ИИ-помощник по документам обещает решить эту проблему. Полезен он не тем, что уверенно отвечает на любой вопрос, а тем, что находит проверяемый фрагмент и показывает, откуда взял ответ.
Чем RAG отличается от обычного чата
Обычный чат может объяснить термин, но не знает вашу последнюю инструкцию о выдаче оборудования. Если загрузить файл вручную, он получит контекст конкретного разговора. RAG превращает поиск и подбор контекста в повторяемый процесс: сотрудник задаёт вопрос, приложение ищет нужные куски в разрешённой коллекции и передаёт их модели. Важно различать доступ к файлам и фактическое использование найденного текста в ответе.
Представим сервисный отдел: клиент спрашивает, какие документы нужны для обращения. Помощник должен найти действующую внутреннюю памятку, указать её дату и процитировать нужный пункт, а не сочинить универсальный список. Это редакционный пример сценария, а не описание услуги KOMTEK. Если памятки нет или она противоречит другому документу, полезный ответ — сообщить об этом и предложить проверку ответственным сотрудником.
Почему загрузить все PDF недостаточно
В PDF может быть текстовый слой, скан страницы, таблица или схема. До построения базы проверьте, что извлекается именно содержимое, а не набор случайных символов. Для сканов нужен этап OCR — распознавание текста на изображении. Сложные таблицы проверяйте отдельно: потерянная связь между названием и числом способна превратить правильный прайс в неверный ответ. На нескольких страницах сравните результат извлечения с оригиналом.
Положите рядом документы одной темы и найдите повторы, старые редакции, черновики и файлы без владельца. Для каждого источника полезно хранить название, дату, статус, язык и раздел. Введите правило: в поисковой базе остаются утверждённые версии, а архив помечается явно. Изменение файла должно приводить к обновлению индекса; удаление источника — к исчезновению его фрагментов из выдачи. Иначе помощник будет отвечать по прошлому состоянию компании.
Это схема процесса, а не измерение скорости. Проверка доступа должна происходить до передачи найденного текста модели.
Фрагменты, embeddings и смешанный поиск
Длинный документ разбивают на смысловые фрагменты, сохраняя заголовок раздела и соседний контекст. Embedding — числовое представление текста для поиска по смысловой близости. Оно не является кратким пересказом или доказательством правильности. Векторный поиск помогает найти похожую формулировку, но точный артикул, код ошибки или название модели часто удобнее искать по ключевым словам. Поэтому для рабочей базы стоит отдельно протестировать оба типа запросов.
Не выбирайте размер фрагмента только по красивому числу из чужого руководства. Слишком маленький кусок теряет условие и исключения; слишком большой добавляет нерелевантный текст. Начните с естественных разделов и проверяйте реальные вопросы. Для русского и узбекского соберите пары запросов на двух языках: похожая тема ещё не означает одинаковое качество выдачи. При смене embedding-модели оцените необходимость переиндексации: числовые представления разных моделей нельзя автоматически считать совместимыми.
Как проверять ответы без выдуманных рейтингов
Составьте тестовый набор из реальных вопросов сотрудников. Для каждого укажите эталонный источник и допустимый ответ: важны смысл, условия и дата, а не совпадение слов. Отдельно добавьте вопрос с опечаткой, сокращением, кодом товара, смешением RU/UZ и несуществующим правилом. Проверяйте два этапа: нашёлся ли нужный источник и правильно ли модель использовала найденный текст. Это помогает отличить проблему поиска от проблемы формулировки ответа.
Дайте системе вопросы вне базы: например, о новом условии, которое ещё не утверждено. Ожидайте явное сообщение о нехватке данных. Затем измените тестовый документ и убедитесь, что ответ обновился. Ссылку в готовом ответе откройте вручную: документ может существовать, но не подтверждать именно заявленный факт. Любые показатели качества считайте на своём наборе и подписывайте размер выборки; не переносите чужую точность на вашу коллекцию.
Права доступа важнее вежливого запрета в промпте
Не просите модель просто «не показывать секретное». Ограничение должно работать в приложении и поиске: пользователь получает только те фрагменты, которые вправе открыть сам. Проверяйте права при каждом запросе, включая историю разговора, кеш и ссылки на оригиналы. Общая база без фильтра по роли может случайно передать закрытый фрагмент в контекст, даже если итоговый ответ его не покажет. Это уже нарушение границы доступа.
В тесте используйте две учебные роли и документ, доступный только одной из них. После смены роли проверьте поиск, историю и скачивание файла. Документ считайте данными, а не источником команд: внутри может оказаться фраза, требующая игнорировать правила. Для такого помощника обычно достаточно режима чтения. Не выдавайте ему права удалять файлы или менять бизнес-записи только потому, что он умеет отвечать на вопросы.
Локальный RAG или облачный сервис
Локальная система даёт больше контроля над размещением компонентов, но требует обслуживания: обновлений, резервных копий, мониторинга и защиты сети. «Запущено на моём ПК» не означает «ничего никуда не отправляется». Проверьте отдельно OCR, embedding-модель, языковую модель, журналы, аналитические плагины и резервное хранилище. Любой из этих этапов может использовать внешнее API. Документируйте маршрут данных до подключения реальных материалов.
Облако проще для пилота, но тариф модели — не весь бюджет. Учитывайте поиск, хранение, обработку файлов, повторные запросы и время проверки ответов. Для небольшого набора документов не обязательно покупать мощную видеокарту заранее: поиск и извлечение текста можно оценить отдельно от генерации. Если нужен локальный запуск языковой модели, требования зависят от её размера и контекста. Не выбирайте железо по одному слову RAG в названии программы.
Практический план пилота
Выберите одну задачу: поиск по техническим памяткам, а не «помощник для всей компании». Назначьте владельца источников и человека, который проверяет ответы. Соберите чистую коллекцию, извлеките текст, настройте поиск, затем подключите генерацию со ссылками. Сначала покажите результат небольшой группе. Записывайте тип ошибки без лишних персональных данных: неверная версия, не найденный фрагмент, неправильное исключение или недоступная ссылка.
Перед расширением договоритесь о поддержке: кто обновляет файлы, как сообщают об ошибке, когда отключают выдачу по спорному источнику. Полезный критерий пилота — сотрудник находит подтверждённый ответ быстрее, чем раньше, а не просто получает больше сообщений. Если после проверки документа всё равно приходится переписывать ответ целиком, сначала исправьте базу и поиск. Добавление более дорогой модели не заменяет порядок в материалах.
Типичные ошибки при внедрении
Не смешивайте действующие инструкции с архивом без меток. Не принимайте уверенный стиль ответа за достоверность и наличие ссылки — за доказательство. Не публикуйте в базе пароли, токены и файлы, не предназначенные для выбранной роли. Не заменяйте обновление индекса повторной загрузкой всего архива без проверки удаления. Не делайте общедоступный интерфейс раньше тестов прав доступа.
И ещё: не обещайте сотрудникам, что помощник знает абсолютно всё. Покажите кнопку открытия источника, дату материала и путь обращения к человеку. Для рабочих мест полезны надёжный SSD, достаточная оперативная память и удобный монитор, но конкретную конфигурацию выбирают после пробного запуска выбранных компонентов. Аппаратные требования и качество RAG — разные вопросы: быстрый компьютер способен быстрее выдать и неправильный ответ.
На сайте KOMTEK также разобран порядок проверки ответов ИИ и защиты данных: он пригодится при оценке ответов по внутренним документам.
FAQ
RAG обучает модель на наших документах?
Нет, сам подход предполагает поиск и передачу фрагментов в контекст. Дообучение — отдельный процесс.
Можно ли работать с отсканированным PDF?
Да, если сначала корректно распознать текст. Таблицы и числа обязательно сравнивают с оригиналом.
Нужна ли видеокарта для поиска?
Не обязательно. Требования генерации зависят от модели и места её запуска; поиск оценивают отдельно.
Можно ли задавать вопросы на узбекском?
Можно при поддержке выбранных компонентов. Качество проверяют на своих RU/UZ-вопросах, а не по общей рекламе модели.
Почему ответ содержит неверную ссылку?
Нужно проверить поиск, связь фрагмента с документом и генерацию. Ссылка должна подтверждать факт, а не просто вести на существующий файл.
Официальные источники
Технические сведения сверены 5 октября 2026 года. Практические примеры — редакционные сценарии, а не измеренные тесты продуктов или гарантия результата.